
从 Ray 角度分析 OpenRLHF 和 veRL 的工程设计
1. Ray
1.1 Ray 的核心概念
在传统的编程中,我们经常使用到 2 个核心概念: function 和 class。而在分布式系统中,我们希望可以分布式并行执行这些 function 和 class。Ray 使用装饰器 @ray.remote 来将 function 包装成 Ray task,将 class 包装成 Ray actor,包装过后的结果可以在远端并行执行。接下来我们就来细看 task/actor (注意,这里的 actor 是 Ray 中的概念,不是 RLHF-PPO 中 Actor 模型的概念)
1.1.1 Ray Task
要将 Python 函数 f 转换为“remote function ”(可以远程和异步执行的函数),我们使用 @ray.remote 装饰器声明该函数。然后通过 f.remote()调用函数将立即返回 future (future 是对最终输出的引用),实际的函数执行将在后台进行(我们称此执行为任务)。
import ray
from typing import List

# Initialize Ray
ray.init()

@ray.remote
def square(x: int) -> int:
    """
    A remote function that computes the square of a given integer.

    Args:
        x (int): The input integer.

    Returns:
        int: The square of the input integer.
    """
    return x * x

if __name__ == "__main__":
    """
    Main driver process that initializes workers and executes parallel computations.

    - Creates 4 worker processes that run remotely.
    - Uses `square.remote(i)` to execute `square(i)` remotely.
    - `ray.get(futures)` blocks execution until all computations are complete.
    - Finally, prints the computed results.
    # 创建4个worker进程,可以在远端并行执行。
    # 每执行1次f.remote(i),会发生以下事情:
    # - 创建1个worker进程,它将在远端执行函数f(i)
    # - 在driver进程上立刻返回一个引用(feature),该引用指向f(i)远程计算的结果
    """

    # Create a list of remote task futures
    futures: List[ray.ObjectRef] = [square.remote(i) for i in range(4)]

    # Wait for all remote tasks to complete and collect results
    # 阻塞/同步操作:等待4个worker进程全部计算完毕
    results: List[int] = ray.get(futures)  # Fixed syntax error (removed extra `)`)

    # Print final results after all computations are complete
    # 确保全部计算完毕后,在driver进程上print结果
print(f"The final result is: {results}") # Expected output: [0, 1, 4, 9]由于调用 f.remote(i)立即返回,可以通过运行该行四次并行执行 f 的四个副本。
1.1.2 Task Dependencies
任务也可以依赖于其他任务。下面, multiply_matrices 任务使用两个 create_matrix 任务的输出,因此它将在前两个任务执行完毕后才开始执行。前两个任务的输出将自动作为参数传递给第三个任务, future 将被替换为相应的值)。通过这种方式,任务可以组合在一起,具有任意 DAG 依赖性。
import ray
import numpy as np
from typing import Tuple

# Initialize Ray
ray.init()

@ray.remote
def create_matrix(size: Tuple[int, int]) -> np.ndarray:
    """
    Creates a matrix with normally distributed random values.

    Args:
        size (Tuple[int, int]): The shape of the matrix (rows, columns).

    Returns:
        np.ndarray: A matrix of given size with values drawn from a normal distribution.
    """
    return np.random.normal(size=size)

@ray.remote
def multiply_matrices(x: np.ndarray, y: np.ndarray) -> np.ndarray:
    """
    Multiplies two matrices using NumPy's dot product.

    Args:
        x (np.ndarray): The first matrix.
        y (np.ndarray): The second matrix.

    Returns:
        np.ndarray: The result of matrix multiplication (dot product).
    """
    return np.dot(x, y)

if __name__ == "__main__":
    """
    Main driver process to perform parallel matrix creation and multiplication using Ray.

    - Creates two large matrices remotely.
    - Multiplies them asynchronously using Ray remote functions.
    - Fetches and prints the result.
    """

    # Create two 1000x1000 matrices remotely
    x_id = create_matrix.remote((1000, 1000))
    y_id = create_matrix.remote((1000, 1000))

    # Perform matrix multiplication remotely
    z_id = multiply_matrices.remote(x_id, y_id)

    # Retrieve and print the final result
    z = ray.get(z_id)
print("Matrix multiplication completed. Result shape:", z.shape)1.1.3 Ray Actor
Ray 允许您 @ray.remote 装饰器将 Python 类进行声明。每当类被实例化时, Ray 会在集群中的某个地方创建一个新的“actor ”,这是一个运行进程并保存 actor 对象的副本。对该 actor 的方法调用变成在 actor 进程上运行的任务,可以访问和修改 actor 的状态。通过这种方式, actors 允许在多个任务之间共享可变状态,而远程函数则不允许。
各个 actors 串行执行(每个单独的方法都是原子的),因此没有竞态条件。可以通过创建多个 actors 来实现并行性。
import ray
from typing import Any

# Initialize Ray
ray.init()

@ray.remote
class Counter:
    """
    A Ray remote actor class representing a counter.

    This counter maintains an internal state `x`, which can be incremented
    and retrieved remotely using Ray actors.
    """

    def __init__(self) -> None:
        """Initialize the counter with a starting value of 0."""
        self.x: int = 0

    def inc(self) -> None:
        """Increment the counter by 1."""
        self.x += 1

    def get_value(self) -> int:
        """Retrieve the current value of the counter.

        Returns:
            int: The current counter value.
        """
        return self.x

# ===================================================================
# 创建driver进程,运行main
# ===================================================================
if __name__ == "__main__":
    # ===================================================================
    # 创建1个worker进程,具体做了以下事情:
    # - 在远端创建Counter实例
    # - 在driver端即刻返回对该实例的引用c(称为actor handler)
    # - 我们可以在Ray集群的任何节点上传递和使用这个actor handler。即在任何地方,
    #   我们可以通过c来invoke它对应Counter实例下的各种方法
    # ===================================================================
    """
    Main driver process that creates and interacts with a remote Counter actor.

    - Creates a Counter actor instance remotely.
    - Calls methods on the actor instance asynchronously.
    - Uses `ray.get()` to fetch results from remote method calls.
    """

    # Create a remote Counter actor instance
    c: Any = Counter.remote()

    # Retrieve and print the initial value of the counter
    print(ray.get(c.get_value.remote()))  # Expected output: 0

    # ===================================================================
    # 阻塞/同步:通过c来invoke远端Counter实例的get_value()方法,并确保方法执行完毕。
    # 执行完毕后才能接着执行driver进程上剩下的代码操作
    # ===================================================================
    # Increment the counter twice asynchronously
    c.inc.remote()
    c.inc.remote()

    # Retrieve and print the updated value of the counter
print(ray.get(c.get_value.remote())) # Expected output: 2上述示例是 actors 的最简单用法。Counter.remote()行创建了一个新的 actor 进程,该进程具有 Counter 对象的副本。对 c.get_value.remote()和 c.inc.remote()的调用在远程 actor 进程上执行任务并修改 actor 的状态。
1.1.4 Actor Handles
在上述示例中,我们仅从主 Python 脚本调用 actor 上的方法。actors 最强大的方面之一是我们可以传递 actor 的句柄,这允许其他 actors 或其他任务都调用同一个 actor 上的方法。
以下示例创建了一个存储消息的 actor。几个 woker 任务反复将消息推送到 actor,主 Python 脚本定期读取消息。
import time
import ray
from typing import List

@ray.remote
class MessageActor:
    """
    A Ray remote actor class that stores and retrieves messages.

    The actor allows multiple workers to push messages asynchronously
    while enabling periodic retrieval and clearing of stored messages.
    """

    def __init__(self) -> None:
        """Initialize the message storage as an empty list."""
        self.messages: List[str] = []

    def add_message(self, message: str) -> None:
        """
        Adds a message to the internal storage.

        Args:
            message (str): The message to be added.
        """
        self.messages.append(message)

    def get_and_clear_messages(self) -> List[str]:
        """
        Retrieves all stored messages and clears the storage.

        Returns:
            List[str]: A list of messages retrieved before clearing.
        """
        messages = self.messages
        self.messages = []
        return messages

@ray.remote
def worker(message_actor: MessageActor, worker_id: int) -> None:
    """
    Worker function that continuously sends messages to the message actor.

    Args:
        message_actor (MessageActor): A reference to the remote MessageActor.
        worker_id (int): Unique identifier for the worker.
    """
    for i in range(100):
        time.sleep(1)  # Simulate some processing time
        message_actor.add_message.remote(f"Message {i} from worker {worker_id}.")

if __name__ == "__main__":
    """
    Main driver process:
    - Creates a MessageActor instance remotely.
    - Launches 3 workers that asynchronously send messages.
    - Periodically fetches and prints messages from the actor.
    """

    # Initialize Ray
    ray.init()

    # Create a remote message actor instance
    message_actor = MessageActor.remote()

    # Start 3 worker tasks that send messages to the actor
    workers = [worker.remote(message_actor, j) for j in range(3)]

    # Periodically fetch and print messages
    for _ in range(100):
        new_messages = ray.get(message_actor.get_and_clear_messages.remote())
        if new_messages:
            print("New messages:", new_messages)
        time.sleep(1)

# This script prints something like the following:
# New messages: []
# New messages: ['Message 0 from worker 1.', 'Message 0 from worker 0.']
# New messages: ['Message 0 from worker 2.', 'Message 1 from worker 1.', 'Message 1 from worker 0.', 'Message 1 from worker 2.']
# New messages: ['Message 2 from worker 1.', 'Message 2 from worker 0.', 'Message 2 from worker 2.']
# New messages: ['Message 3 from worker 2.', 'Message 3 from worker 1.', 'Message 3 from worker 0.']
# New messages: ['Message 4 from worker 2.', 'Message 4 from worker 0.', 'Message 4 from worker 1.']
# New messages: ['Message 5 from worker 2.', 'Message 5 from worker 0.', 'Message 5 from worker 1.']actors 非常强大。它们允许您将 Python 类实例化为可以从其他 actors 和任务甚至其他应用程序查询的微服务。
Tasks 和 actors 是 Ray 提供的核心抽象。这两个概念非常通用,可以用来实现复杂的应用程序,包括 Ray 内置的用于强化学习、超参数调整、加速 Pandas 等的库。
1.1.5 Ray cluster 架构
现在我们已经通过以上例子对 Ray 运作原理有了一些基本感知,我们来进一步探索一个Ray cluster 的组成:
- 在一个 Ray cluster 中,会有一台 head node 和若干 worker node
- Driver process 是一种特殊的 worker process,它一般负责执行 top-level application (例如 Python 中的
__main__),它负责提交想要执行的任务,但却不负责实际执行它们。理论上 driver process 可以运行在任何一台 node 内,但默认创建在 head node 内。 - Worker process 负责实际任务的执行(执行 Ray Task 或 Ray Actor 中的方法)。
- 每台 node 中还有一个 Raylet process,它负责管控每台 node 的调度器和共享资源的分配。
- Head node 中的 GCS 将会负责维护整个 Ray cluster 的相关服务。
1.2 Ray 启动方式
Ray 提供了多种语言的调用接口,但我们用的最多的还是 Python 接口,一般我们会运行一个 Python 脚本,并在这个脚本中运行ray.init()就自动创建了一个 Ray 集群,通常这个脚本的运行进程叫做 driver process。除此之外,我们也可以通过在命令行运行ray start 手动启动 Ray 集群,并在脚本中去 attach 到这个集群上。
1.3 运行逻辑
Ray 集群在操作系统层面上主要体现为节点上一组驻留的进程池。当我们创建一个函数或者一个类,并用@ray.remote装饰后,这个函数/类就成为了一个可调度的 Task/Actor。我们可以调用这个 Task/Actor 的 remote 方法,按照调度策略将这个 Task/Actor 分配到某个节点的进程池上运行或初始化。对于 driver 来说,分发出去的任务是异步运行的,因此还需要通过 ray.get去获取异步运行结果。
Task/Actor 所传入的参数和返回的结果都会先被 序列化 为一个 Object,存放在 Ray 集群的 Object Store 里面。从 Ray 的层面看,一个 Ray 集群中所有节点的 CPU memory 共同组成了一个 (Shared) Object Store,节点之间在逻辑上是共享这个 Object Store 的所有资源的,因此我们(在逻辑上)不需要关心哪个对象存放在哪个节点,只需要ray.get这个 Object 的 reference,然后 Ray 就会自动拿取实际的 Object 并反序列化到运行进程中。
Actor 可以通过组合的方式创建和运行,即在一个 Actor 中可以 remote 创建和调用另一个 Actor。值得注意的是,在现版本的 Ray 中是不能用继承的方式去继承一个 Actor 的方法的,所以我们只会在最终的子类上用 @ray.remote 装饰。
1.4 资源调度
在创建 Actor 时,我们可以指定这个 Actor 所需要的运行资源(num_cpus, num_gpus 等),并从资源池中获取这些资源,若所需的资源不足则无法立即调度,这种方式只能实现资源的独占。同时我们还可以事先分配一个资源组(placement group),并将一个或多个 Actor 分配到这个资源组的一个 bundle 上,实现资源的独占或共享。显然后者的资源调度方式更为灵活,像 veRL、OpenRLHF 均采用了这个策略。
remote_ray_worker = ray.remote(
    num_gpus=self.num_gpus_per_worker,
    scheduling_strategy=PlacementGroupSchedulingStrategy(
        placement_group=self.resource_group.ray_pg,
        placement_group_bundle_index=worker_rank,
    ),
    runtime_env={"env_vars": env_vars},
    name=worker_name,
    max_concurrency=2,
)(self.worker_cls).remote(
    self.num_workers,
    worker_rank,
    model_cls=self.model_cls,
    model_args=self.model_args,
    kwargs,
)例如 RLHF 中的一个 Actor 模块,开启 DP=4,那么就可以创建一个 GPU=4 的资源组(暂时忽略 CPU 资源),并建立 4 个 GPU=1 的 bundle,然后对每一个 Actor worker 的分片,依次分配一个资源组的 bundle 即可。
2. 解析 OpenRLHF
从工程逻辑的角度看, OpenRLHF 的代码较为简洁易懂,而 veRL 有一些工程实现上的小 trick。所以我们先从 OpenRLHF 入手解读。
核心代码文件有:
- CLI/train_ppo_ray.py:启动脚本,训练入口,各种配置项以及各个模型的 Ray 初始化都写在里面;
- trainer/ppo_trainer.py: PPOTrainer 实现,即 PPO 算法主体,包含了训练的基本流程,即先生成 rollout,再训练;
- trainer/ppo_utils/experience_maker.py:生成 rollout 的地方,在
RemoteExperienceMaker的make_experience_list开始可以看到一个 rollout 的数据是如何生产的,包括怎么调用 vLLM,怎么算 logprob、kl、reward 等; - OpenRLHF/utils/DeepSpeed/DeepSpeed.py:做
deepspeed.initialize的地方。 - trainer/Ray/launcher.py:核心调度组件 PPORayActorGroup,以及 Ref Actor 和 Reward Actor 的实现
- trainer/Ray/ppo_actor.py: Actor 和 Actor Trainer (继承 PPOTrainer)的实现, Ray 版本的
PPOTrainer,相较于普通版本多了一些通信上的同步。_broadcast_to_vllm是推理部分(vLLM)与训练部分(DeepSpeed)的同步逻辑,目前的状态是训练部分的 rank0 和所有 vLLM worker 构建一个 process group,由训练的 rank0 broadcast 给所有的 vLLM worker; - trainer/Ray/ppo_critic.py: Critic 和 Critic Trainer (继承 PPOTrainer)的实现
- trainer/Ray/vllm_engine.py: vLLM Rollout Actor 的实现
- trainer/Ray/vllm_worker_wrap.py: vLLM Worker 子类,同步 Actor 和 Rollout 模块权重的逻辑
先放一张整体架构图:
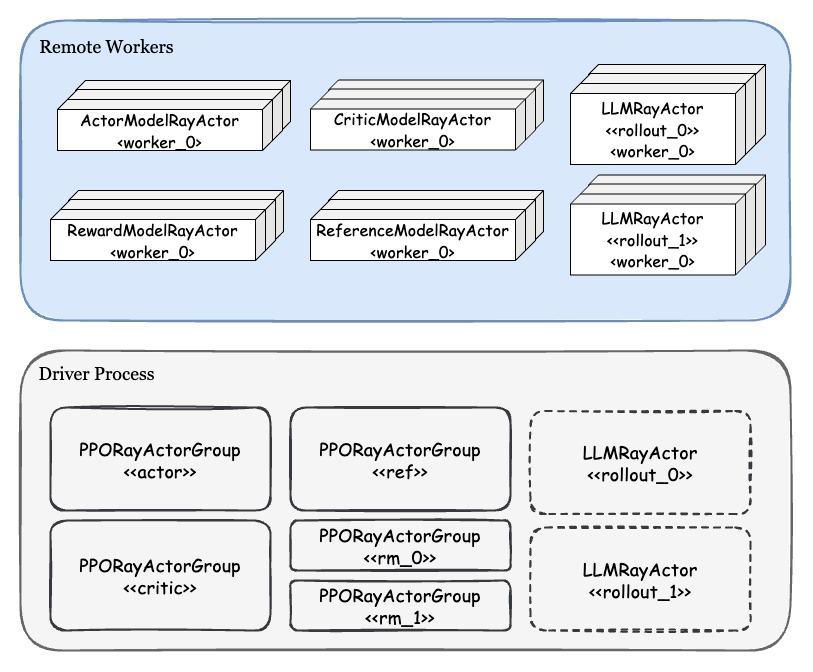
上图区分了 driver process 和 remote 上存在的实例。在 Driver 上有着各种模块对应的 PPORayActorGroup 实例,每一个 Group 实例代表着逻辑上的一个完整模型,而 Group 中的每个 remote worker 是这个完整模型的 DP 分片。对于 Rollout 模块而言, driver 上存在一个或多个 LLMRayActor 的 handle,每个 Actor 代表一个 vLLM engine,也就是一个完整的 DP 模型,每个 engine 内部还会通过 Ray 启动 TP worker Actor (这个 Ray 会 attach 到已有的 cluster,不会新建一个)。
Group 中 创建 worker 是依次进行的:首先创建 rank0 worker (master actor),并由它获取整个 Group 建立通信的 addr 和 port,接着依次创建其他 worker 并传入通信的 addr 和 port。在初始化模型时,统一作 通信组的初始化。注意 Group 之间的通信是相互隔离的,因此每一个 Group 的训练就可以等价于平时做的多进程模型训练。
因此在 Ray 的抽象下,各个模块都可以看成是独立的 multi-process training / generate,而模块之间的交互是通过 Object Store 和 Object Ref 做数据的收发来实现的。我们可以看到 Ray 在底层帮我们隐藏了许多技术细节,从而简化了多模型协同训练的搭建逻辑。
2.1 训推模块与 backend
我们首先整理一下 PPO 算法中各个模块的功能和职责:
- Actor:训练模块,前向反向都计算,需要更新权重
- Critic:训练 + Eval 模块,前向反向都计算,需要更新权重
- Rollout:批量推理模块,用于生成 trace samples,需要和 Actor 同步权重
- RM、Ref: Eval 模块,仅前向计算,权重不更新
理论上,训练模块可以采用市面上所有的训练引擎充当 backend (torch DDP、FSDP、torchtitan、Megatron、DeepSpeed 等),批量推理模块可以采用所有的推理引擎充当 backend (SGLang、vLLM、TGI 等)。但 Eval 模块训练推理引擎都可以做,需要仔细斟酌要用哪个,考虑到训练和推理引擎的精度差异(logit 数值上约有 10% 的相对误差),在涉及关键的 loss 计算还是要优先确保精度而非速度,所以我们可能会更倾向于在训练引擎跑一个 plain forward。
在 OpenRLHF 中,训练模块采用 DeepSpeed,它的好处在于和现有 HF 生态融合地非常好,基本没有兼容性问题,也不太依赖特定版本,当然用 FSDP 也差不多。推理模块用 vLLM,同时支持了 DP (多个 engine)、TP (每个 engine 内部)并行。
2.2 Ray 资源调度与 colocate
所谓 colocate,在这里的含义就是多个 Ray Actor 共享同一个 GPU 资源。由于 OpenRLHF 中每个 Ray Actor 都是某个模块的 DP (对 vLLM 而言是 DP+TP)分片,因此可以理解为不同模块对应的分片同时存放于一张卡上。这里的“同时存放”是概念上的,不一定要同时占用显存,实际上每个模块的分片可以通过 offload/reload 轮流占用显存。
OpenRLHF 提供了三种 colocate 方式:colocate_actor_ref,colocate_critic_reward 和 colocate_all_models。其中 colocate_all_models既包括了前两者,又增加了 Actor 和 Rollout 的 colocate。这三种 colocate 的实现方式都是类似的,也就是上面提到的事先分配资源组并给每个 worker 分片指定 bundle 的方式。
具体而言, PPO 的每个模块在逻辑上属于一个 PPORayActorGroup,如果模块之间存在 colocate,则往这个 Group 中传入同一个 placement_group (pg),然后在 Group 内部分配每个 worker 的 bundle。由于我们希望至多 5 种模块的 worker 共享一张卡,因此设置 num_gpus_per_actor=0.2 可以刚好满足资源需求。【不过这里存在一个 caveat:当开启 colocate_all_models并存在多个 Reward Model 时,那就有 6 个及以上的模块了,那么资源分配应该会失败,看官方是否认为这是个问题吧。】
不做 colocate 的模块则在 Group 内部新建资源组并分配 bundle,每个 DP 分片独占 1 个 GPU,因此也不会抢占其他 colocate 模块的 GPU 资源。
这里需要尤其关注 Actor 和 Rollout colocate 的情况。在 OpenRLHF 中, Actor 和 Rollout 是独立的两个模型,一个放在 DeepSpeed 训练引擎,一个放在 vLLM 中,它们需要保持权重的同步。因此当 Actor 更新时,需要将新权重 broadcast 到 Rollout 上。由于两个模块时 colocate 到一张卡上的,而 NCCL 无法做同一张卡上两个进程的通信,所以需要用 CUDA IPC 做进程间通信。通信组是在 Actor 的 worker0 和所有 vLLM engine 的所有 worker 之间建立的,权重同步分两步:一是在 Actor workers 内部 all_gather 权重,二是由 worker0 代表 Actor 向所有 Rollout 实例 broadcast 权重。
2.3 Data/Control Flow 梳理
OpenRLHF 各个模块写的非常整洁,然而它缺少了贯穿这些模块的统一的 Control 模块,使得实际的执行流程分散在各个模块之间,这同时也是这个代码库最难理解和 track 的部分。
从启动脚本出发,完成参数初始化、各个模块建立和模型初始化后,控制逻辑交给了隶属于 Actor 的 Group,调用 async_fit_actor_model,这个方法内会调用所有 Actor worker 的 fit方法,其本质是调用了PPOTrainer.fit,至此所有 worker 同时开训。
此时控制逻辑在每个 Actor worker 的 trainer 中,同时每个 Actor worker 都绑定到一组 (Ref, Critic, RMs) worker 上, Actor worker 生成或需要的数据只通过这些绑定的 worker 传输。理论上由于所有 Actor、Ref、Critic、RM 都是 DP 分片, Actor worker 向任何一个分片发送/接受数据都是等价的,实际上 OpenRLHF 是通过 round-robin 轮询的策略挑选组合的。
后续的控制逻辑比较分散,我整理后展示其伪代码如下:
# In `PPOTrainer.fit`: https://github.com/OpenRLHF/OpenRLHF/blob/17bbb313551a3af3cdd213d8b9e7522fe9c6271b/openrlhf/trainer/ppo_trainer.py#L189
for eposide in range(num_eposides):
    for prompt in prompt_dataloader:
        sample_and_generate_rollout() # `micro_rollout_bs` per step, total `rollout_bs`
        make_exps() # all_batch (i.e. `rollout_bs`)
        put_in_replay_buffer()
        # In `ActorPPOTrainer.ppo_train`: https://github.com/OpenRLHF/OpenRLHF/blob/17bbb313551a3af3cdd213d8b9e7522fe9c6271b/openrlhf/trainer/ray/ppo_actor.py#L122
        for epoch in range(num_epochs): # train_bs = micro_train_bs * num_grad_acc
            for exps in replay_buffer:  # micro_train_bs per step
                train(exps)

        clear_replay_buffer()

# In `training_step`: https://github.com/OpenRLHF/OpenRLHF/blob/17bbb313551a3af3cdd213d8b9e7522fe9c6271b/openrlhf/trainer/ppo_trainer.py#L327
# 实际上 actor 和 critic 会各自运行自己的 training step
train():
    train_actor()
    train_critic()

# In `training_step_actor`: https://github.com/OpenRLHF/OpenRLHF/blob/273422305ea17362319f5569c6f9ef5a16b49cb0/openrlhf/trainer/ppo_trainer.py#L336
train_actor():
    cal_actor_loss()
    cal_kl_loss() # optional
    cal_aux_loss() # optional
    backward()
    pretrain_forward_and_cal_ptx_loss()
    backward()
    step()
    ema_update()

# In `training_step_critic`: https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ppo_trainer.py#L452
train_critic():
    cal_critic_loss()
    cal_aux_loss()
    backward()
step()需要注意的是,这些所有的控制逻辑全部由 Actor workers 执行,同时每一个 Actor worker 负责控制对应它绑定的 (Actor, Ref, Critic, RM, Rollout) 这个 worker 组的 data flow,因此 Actor workers 的计算和通信负担是非常重的。当然这里只是直观上的结论,具体的性能瓶颈仍然需要跑实验看下。
3. 解析 veRL
veRL 设计上最好的一点就是模块间充分的解耦,这使得修改和扩展自定义模块非常容易,同时框架使用了很多 Python 语法糖来巧妙的让一个 Ray Actor 在多种角色之间自由切换。
当前整个代码库基本都建立在 Ray 之上,我们这里主要关注 veRL 与 Ray + FSDP 相关的工程部分,相对而言会忽略 Megatron 部分以及绝大部分的模型、算法细节,不过 veRL 对于这部分做了充分的解耦,阅读和修改代码不会有太大的困难。
相关的核心代码文件有:
- trainer/main_ppo.py:启动文件
- workers/fsdp_workers.py:所有与 FSDP backend 相关的 Worker 实现
- PPO/ray_trainer.py: Trainer 和资源管理
- single_controller/Ray/base.py:基于 Ray 的 colocate 和 WorkerGroup 实现
- workers/rollout/vllm_rollout/vllm_rollout.py: vLLM Rollout 实现
周边代码还有:
- single_controller/base/decorator.py:数据分发策略
- single_controller/base/worker.py: Worker 基类
- single_controller/base/worker_group.py: WorkerGroup 基类
首先还是从整体来看框架的组成部分:
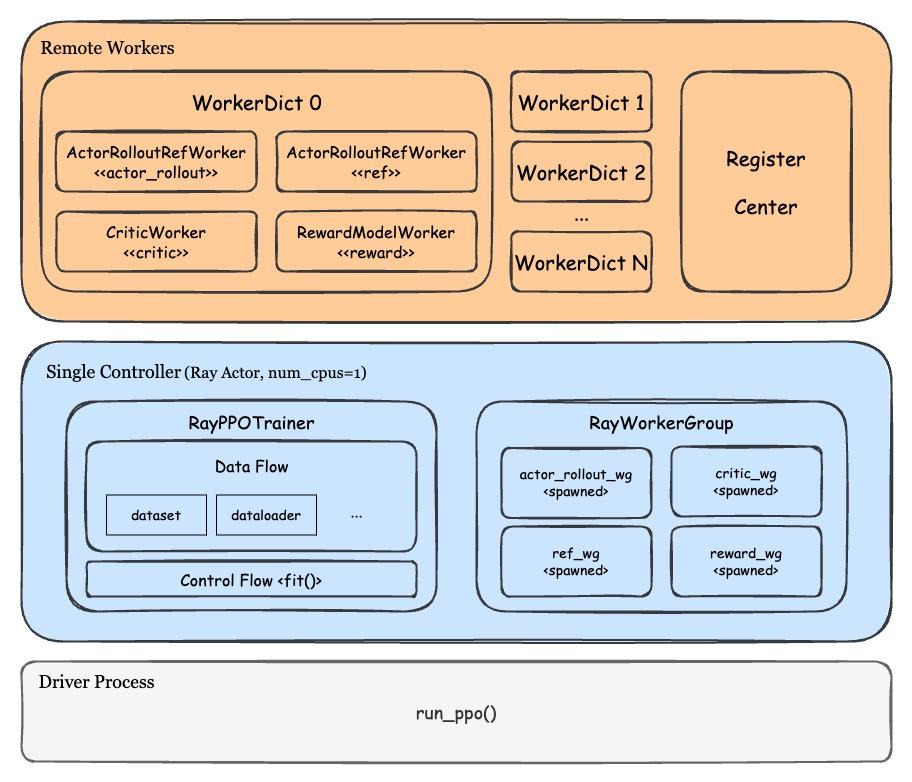
不同于 OpenRLHF 由多个 Actor 控制一组 workers 的 control flow, veRL 的主体控制逻辑集中于一个 Ray Actor 中(veRL 官方称之为 single controller),这个 single controller 仅运行在 CPU 上,负责管理 data flow、control flow、各类数据结构的初始化, WorkerDict 的 remote 创建和调用,以及数据收发的统一管理。由于 single controller 的负载较大,官方推荐 single controller 尽可能调度在非 head 节点上。
这里最精妙的结构是 WorkerDict,它本身只是一个 Worker 的基类,也就是 RLHF 某一个模块的模型分片,但实际上它绑定了 Actor、Critic、Rollout、Ref、Reward 等所有模块的公开方法,因此可以灵活地动态指定或切换一个 WorkerDict 实际代表的模块,可以看作一个万能的 Worker。
在 WorkerDict 之上是一个名为 RayWorkerGroup 的数据结构。它主要是用于从资源组获取资源,动态指定 WorkerDict 的模块(通过 method 的重命名和 rebind 来实现)并创建 WorkerDict,同时作为任务调度器向指定的 WorkerDict 分发执行任务。
3.1 训推模块和 backend
因为 PPO 算法对模块的需求是相同的,因此这部分的分析同 OpenRLHF。那么在 veRL 中,训练模块可以是 FSDP/HSDP 或者 Megatron,推理模块仍然是 vLLM (SGLang 应该在接入中)。
3.2 Ray 调度与 Hybrid Engine
尽管这里的副标题没有提到,但 veRL 实际上也可以做模块之间的 colocate,相比于 OpenRLHF 有限的 3 种 colocate 方式, veRL 理论上可以实现任意的 colocate 组合。从代码上看,我们可以将需要 colocate 的模块绑定到同一个 resource pool 中,然后逐个创建 resource pool 对应的模块 class。
但在实际的源代码中, veRL 目前的策略只有一种,也就是 colocate 所有模块。我个人认为,如果要在现有代码的基础上支持多种(或者任意的) colocate 策略, WorkerDict 和 RayWorkerGroup 可能要大改,至少需要考虑如何建立每个 resource group 的通信组,如何做环境变量的设置,以及如何做不同资源组之间的 method bind/rebind 等等。
所以 veRL 主要强调的还是它的 Hybrid Engine 能力,也就是不同模块共享同一个数据结构(WorkerDict)和资源组,并且 WorkerDict 可以灵活地在多种模块、多个 engine 之间切换。这个 Hybrid Engine 的定义与 DeepSpeed-Chat 非常接近。
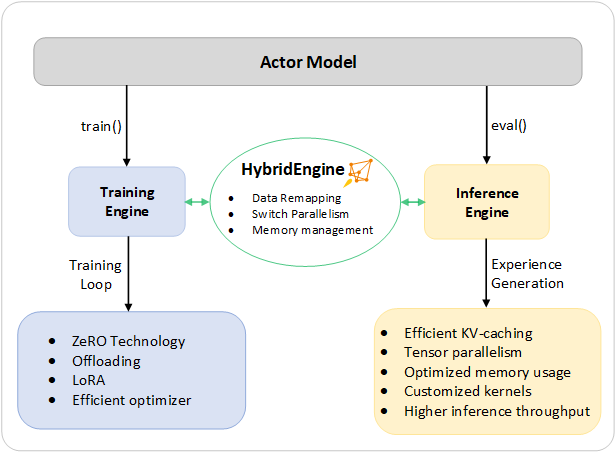
有个非常值得注意的点是,在 veRL 中 Actor 和 Rollout 是共享同一个模型权重的,因此它不需要像 OpenRLHF 一样做权重同步和 CUDA IPC 通信【更正:感谢评论区同学的指正, veRL 通过 ShardingManager 也做了模型的更新和同步,但由于 Actor 和 Rollout 是在同一个进程上的,所以也不需要做通信,此外我还抓到了 veRL 在 vLLM repo 提的 feature request】,但是原生的 vLLM 不支持直接传入模型结构/权重,所以 veRL 还对 vLLM 做了许多 patch 来适配。两种方案哪种更好呢?我觉得 OpenRLHF 实现上更加简单,可维护性和兼容性更好,而 veRL 更节省显存资源,性能上(可能)更好,只能说各有优劣吧。
接下来我们重点来看整个代码库中最 tricky 的部分,也就是如何实现 WorkerDict 的动态特性的。这部分的入口代码仅有几行:
# initialize WorkerGroup
# NOTE: if you want to use a different resource pool for each role, which can support different parallel size,
# you should not use `create_colocated_worker_cls`. Instead, directly pass different resource pool to different worker groups.
# See https://github.com/volcengine/verl/blob/master/examples/ray/tutorial.ipynb for more information.
all_wg = {}
self.wg_dicts = []
for resource_pool, class_dict in self.resource_pool_to_cls.items():
    worker_dict_cls = create_colocated_worker_cls(class_dict=class_dict)
    wg_dict = self.ray_worker_group_cls(resource_pool=resource_pool, ray_cls_with_init=worker_dict_cls)
    spawn_wg = wg_dict.spawn(prefix_set=class_dict.keys())
    all_wg.update(spawn_wg)
    # keep the referece of WorkerDict to support ray >= 2.31. Ref: https://github.com/ray-project/ray/pull/45699
self.wg_dicts.append(wg_dict)这里 class_dict 的类型是 dict[str, RayClassWithInitArgs],前者是一个 key string,后者是一个预先保存初始化 RLHF 模块参数的包装类,取 RayClassWithInitArgs.cls就可以得到原本的 user_defined_cls。key 和 user_defined_cls 的对应关系如下:
| Key | User_defined_cls |
|---|---|
| actor_rollout | ActorRolloutRefWorker |
| critic | CriticWorker |
| ref | ActorRolloutRefWorker |
| rm | RewardModelWorker |
在 create_colocated_worker_cls中包含着 WorkerDict 的初始化逻辑:
class WorkerDict(worker_cls):

    def __init__(self):
        super().__init__()
        self.worker_dict = {}
        for key, user_defined_cls in cls_dict.items():
            user_defined_cls = _unwrap_ray_remote(user_defined_cls)
            # directly instantiate the class without remote
            with patch.dict(os.environ, {'DISABLE_WORKER_INIT': '1'}):
                self.worker_dict[key] = user_defined_cls(*init_args_dict[key].get('args', ()),
init_args_dict[key].get('kwargs', {}))注意哦,在这里 worker_cls就是 Worker,而所有 user_defined_cls 也都继承 Worker。所以 WorkerDict 初始化过程不仅会运行一个 Worker 的完整 __init__ 函数,而且还会创建所有 user_defined_cls 并运行一个不做分布式初始化的 __init__ 函数。因此一个 WorkerDict 其实同时包含了 ActorRolloutRefWorker、CriticWorker、RewardModelWorker的所有实例。
接下来,_bind_workers_method_to_parent函数将这些 user_defined_cls 的所有被@register装饰的公开方法绑定到 WorkerDict 本身的方法中。
通过调试,我们可以看到一个 WorkerDict 绑定了哪些方法:
(Pdb) p self.workers
[Actor(create_colocated_worker_cls.<locals>.WorkerDict, 0beb69e9e6b716d1650b3c4601000000)]

(Pdb) p dir(self.workers[0])
['__init__', '__new__', '__ray_call__', '__ray_ready__', '__ray_terminate__',
'_configure_before_init', '_configure_with_meta', '_get_free_port',
'_get_node_ip', '_get_pid', 'actor_rollout_compute_log_prob', 'actor_rollout_compute_ref_log_prob',
'actor_rollout_execute_func_rank_zero', 'actor_rollout_execute_with_func_generator',
'actor_rollout_generate_sequences', 'actor_rollout_init_model', 'actor_rollout_load_checkpoint',
'actor_rollout_save_checkpoint', 'actor_rollout_update_actor', 'critic_compute_values',
'critic_execute_func_rank_zero', 'critic_execute_with_func_generator', 'critic_init_model',
'critic_load_checkpoint', 'critic_save_checkpoint', 'critic_update_critic', 'execute_func_rank_zero',
'execute_with_func_generator', 'get_availale_master_addr_port', 'get_cuda_visible_devices',
'get_master_addr_port', 'ref_compute_log_prob', 'ref_compute_ref_log_prob',
'ref_execute_func_rank_zero', 'ref_execute_with_func_generator', 'ref_generate_sequences',
'ref_init_model', 'ref_load_checkpoint', 'ref_save_checkpoint', 'ref_update_actor']可以看到有一些带 actor_rollout_、critic_、ref_ 前缀的方法,这些就是新增的绑定方法。
在调用 WorkerDict 这些新增的绑定方法时,实际上是调用了ActorRolloutRefWorker / CriticWorker / RewardModelWorker对应实例的方法, WorkerDict 只是起到一个代理作用。
从 create_colocated_worker_cls 返回后,我们会将这个 WorkerDict 交给 RayWorkerGroup,在这里,除了完成 WorkerDict 的资源分配和创建之外,我们还需要额外做一个工作,那就是将 WorkerDict 新增的绑定方法再绑定到这个RayWorkerGroup上去,这个工作在 _bind_worker_method里面完成。
从代码中可以看出,RayWorkerGroup上的绑定方法具有了自由执行 dispatch、execute 和 collect 方法的功能,可以按照 @register 预先指定的数据分发、集合方案和运行方案来指配每个 WorkerDict 实际接受到/应该返回的数据,这些方案可以从 decorator.py 中找到。
我们从上至下理一下调用的先后顺序,当我们在 RayPPOtrainer 中调用RayWorkerGroup的某个绑定方法时,首先会运行数据分发逻辑(例如 broadcast 和 split),然后执行 execute 逻辑(所有 WorkerDict 都跑任务,或者只有 rank0 跑任务,等等),将任务和数据下发到每个 WorkerDict,每个 WorkerDict 在 remote 拿到数据后开始执行任务,任务执行完成后,结果被 RayWorkerGroup捕获,它随后执行数据的 collect 逻辑(reduce、concat 等),最后返回处理后的数据给 RayPPOtrainer。
那么还剩下最后一个问题,当我们调用 init_model() 时,我们怎么知道它应该调用的是 Critic 的critic_init_model 方法,还是 Ref Model 的 ref_init_model 方法呢? veRL 的处理方法是在原有RayWorkerGroup的基础上,spawn 出 4 个几乎一模一样的RayWorkerGroup,分别命名为 actor_rollout_wg、critic_wg、ref_policy_wg、rm_wg,每个 wg 对应一个 PPO 的模型。然后 veRL 对这些 spawn 出来的 wg 做了一个 rebind,其实就是重命名。例如对于 actor_rollout_wg 而言,它的 actor_rollout_init_model方法就会复制一份,重命名为 init_model,这样调用 actor_rollout_wg.init_model()就等价于调用原来那个 RayWorkerGroup的 actor_rollout_init_model方法,类似地可以对其他 wg 和绑定方法做 rebind 处理。
经过上面的一系列处理后,我们调用 actor_rollout_wg.init_model(),就可以让 remote 的所有 WorkerDict 运行 actor_rollout 的模型初始化函数了。尽管这个工程实现较为复杂,但最后的效果是能让指定的 WorkerDict 运行任何模块的公开方法,并自动处理数据分发和接受逻辑,总体而言是非常精妙的设计!
理解了这个部分,我们就可以跳出技术细节,从宏观上就可以看出, veRL在 Ray 层面的调度非常简单,就是每卡调度一个 WorkerDict 作为 Ray Actor,并让所有模块的对应分片共享这一个 WorkerDict 所分配到的资源。创建每一个 WorkerDict (本质上是 Worker)的方式和 OpenRLHF 基本一致,先创建 rank0 worker,拿到 master addr / port 后,再创建其他 worker。不过 veRL 还创建了一个 register center 用来管理这个 master addr / port,这个 center 就是一个独立的 CPU Ray Actor。
3.3 Data/Control Flow
veRL 采用的 single control 设计将控制逻辑集中在 RayPPOTrainer 里面,首先运行了 init_workers初始化 WorkerDict 及每个模块的模型分片,而 fit 部分就是 PPO 算法的主体逻辑了。RayPPOTrainer里面所有与 wg 相关的 method 调用,都可以参考上面整理的思路来 trace 它的实际运行步骤。
4. OpenRLHF 中基于 Ray 的分布式训练流程
4.1 概要-为什么使用 Ray
对于通常的 RLHF 框架,在训练时会在单卡上同时部署 actor/ref/reward/critic 四类模型,这种单一的部署方式可能存在如下问题:
- 难以突破单卡显存的限制。
- 无法实现更多的并行计算。例如在收集 exp 阶段,拿到
(prompt, responses)结果的四类模型其实可以做并行推理;在训练阶段,拿到 exp 的 actor 和 critic 也可以做并行训练。但受到单卡显存等因素影响,通常的 RLHF 框架中使用更多的是串行。 - 无法独立优化训练和推理过程。诸如 vLLM 之类的框架,是可以用来提升 actor 生成
(prompt, responses)的速度的,而对于其它模型,我们也可能会视算法需要有不同的推理需求。因此我们期望能更加灵活地设计训练、推理过程
而解决以上问题,需要开发者能设计一套较为灵活的分布式计算框架,能够实现资源定制化分配、分布式调度、节点内外通信等目标,同时相关的代码不能太复杂,能够让使用者更专注于算法部分的研发。而 Ray 天然可以帮我们做这件事:我们只需提供自己的资源分配方案,告诉 Ray 我想怎么部署这些模型,不管是分开还是合并部署 Ray 都可以帮我们实现。而复杂的调度策略和通信等事项,就由 Ray 在后台去做,我们无需关心这个过程。
下面我们提供 2 个例子,帮助理解使用 Ray 可以做什么样的“定制化”部署。
4.1.1 非共同部署
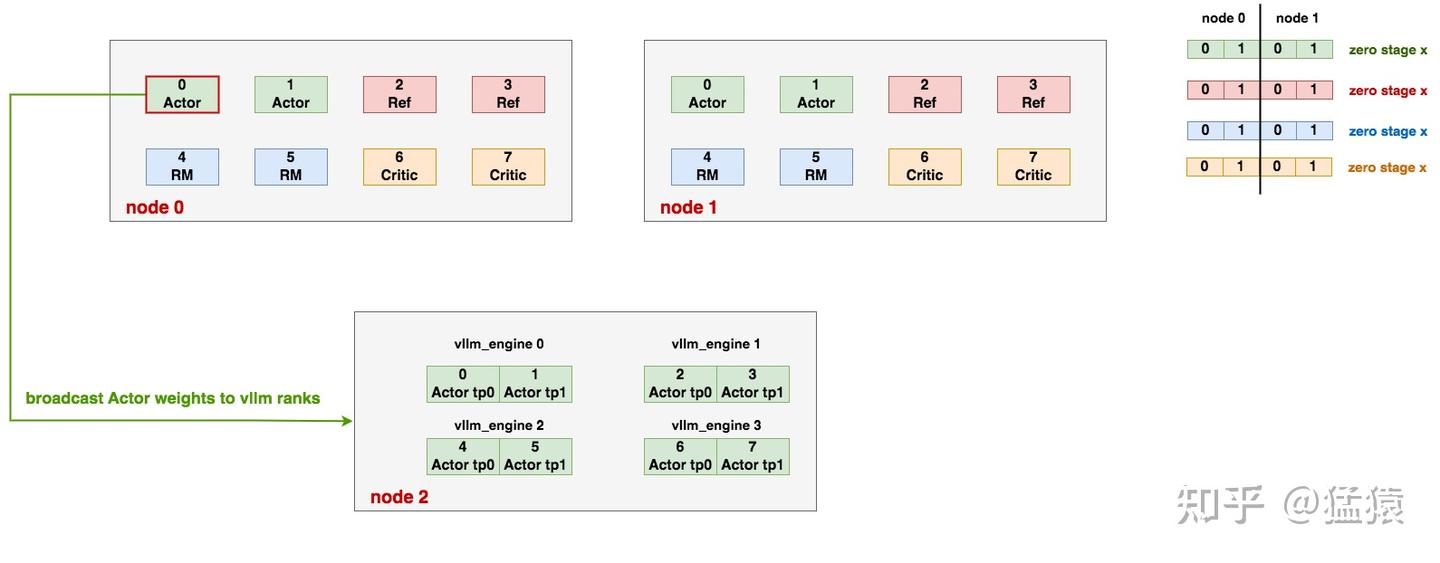
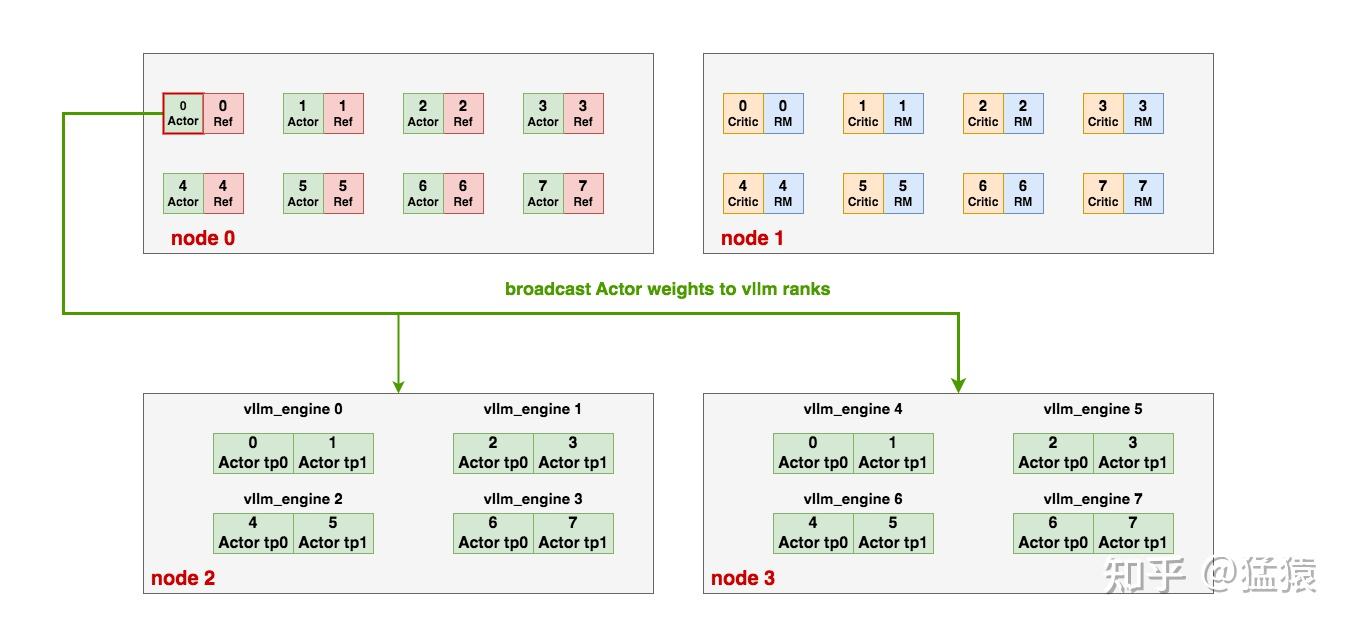
这个例子展示如何完全独立部署各个模型。假设我们有 3 台 node,每台 node 8 张卡。以下展示其中一种可行的部署方式:
4.1.2 (1)部署 4 类模型
在这个例子中, 4 类模型分开部署在 node0 和 node1 上。以 Actor 为例,它分布在“node0 的 gpu0/1 + node1 的 gpu0/1 ”上。这一点是由 Ray 实现的:我们自己定制化资源分配的方案,进而管控模型的分配方式
而当实际训练时,我们还可进一步引入 DeepSpeed zero 做优化:以 Actor 为例,上图中的 4 个 Actor 构成 zero 中的数据并行组(world_size = 4),根据 zero 的配置,我们可以在这 4 张卡间做 optimizer/gradients/weights 的切片
4.1.3 (2)部署 vllm_engines
前文说过,对于 Actor 模型,在收集 exp 阶段我们可以采用 vLLM 之类的框架加速(prompt, responses)的生成。在这个例子中:
- 1 个 vllm_engine 维护着一个 vLLM 实例,每个 vLLM 实例下维护一个完整的 Actor 模型,这里我们还假设一个 vLLM 实例按 tp_size = 2 的方法切割模型。
- 在 node2 中,共有 4 个 vllm_engines (也即 4 个 vLLM 实例),这种分配方式是通过 Ray 实现的。而每个 vLLM 实例内的分布式推理则是由 vLLM 自己管控。
4.1.4 (3) Actor 与 vllm_engines 之间的通讯
我们称:
- vllm_engines 中的 actor 为 vllm_actor
- node0/1 中的 actor 为 ds_actor
在整个训练过程中, vllm_actor 需要和 ds_actor 保持权重一致。我们来看这个一致性是如何维护的:
4.1.5 初始化阶段
假设pretrain路径下存储着 SFT 模型,当我们首次开始训练时, ds_actor 和 vllm_actor 都直接从pretrain中加载权重,两者互不影响,独立加载。
4.1.6 训练中
在 1 个 step 结束后, ds_actor 需要把更新后的权重 broadcast 给 vllm_actor,具体步骤如下:
首先,对
ds_rank0 + all_vllm_ranks创建一个通讯组。在本例中:- node0/gpu0 上的 actor 是 ds_rank0
- node2 中所有的 GPU 构成 all_vllm_ranks。
- 我们就是把这两者纳入一个通讯组内,这个通讯组的 world_size = 9。如果我们多一台 node3 来做 vllm_engines,那么这个通讯组的 world_size = 17,以此类推。
假设我们使用 ds_zero1/2,则 ds_rank0 上维护的是完整的 actor 权重,我们把 ds_rank0 上的权重 broadcast 到每一个 vllm_rank,如有设置 TP, vLLM 会自动帮我们完整接下来的模型切割。
假设我们使用 ds_zero3,则 ds_rank0 上只维护部分 actor 权重,那么:
- ds_rank0 先从 ds_actor 组内 all gather 回完整的模型权重
- 再将完整的模型权重 brocast 给每一个 vllm_rank
4.1.7 从检查点恢复训练(load_checkpoint)
当我们需要从检查点恢复训练时, ds_actor 会负责把检查点权重 broadcast 给 vllm_actor,方式同 2。
4.1.8 (4)整体运作流程
结合开头的图例,我们来简述一下整体运作流程。
首先明确一些表达。例如,
node0中的Actor0/1 + node1中的Actor0/1属于相同的数据并行组,所以接下来我们会用它们在 DP 组中的 rank 来描述它们,也就是分别改称 Actor0/1/2/3。对于其余三类模型也是同理。接着进行分组:
Actor0 / Ref0 / RM0 / Critic0 / vllm_engine0为一组Actor1 / Ref1 / RM1 / Critic1 / vllm_engine1为一组Actor2 / Ref2 / RM2 / Critic2 / vllm_engine2为一组Actor3 / Ref3 / RM3 / Critic3 / vllm_engine3为一组- 你可以把每一组想象成原来的一张单卡,那么它的作用就是负责一个 micro_batch 的训练,这样我们就能大致想象到它们之间是如何配合运作的了。需要注意的是,在我们的例子中,这些实例都是一一对应的(各自有 4 个实例),但在实际操作中,根据不同用户的资源配置,不一定存在这个一一对应的关系。例如你可能用 4 卡部署 Actor, 2 卡部署 Critic, 8 个 vllm_engines...以此类推。不管怎样,我们应该尽量在处理 micro_bathes 的各个组间均匀分配负载,在代码里相关的操作如下:
为每个 actor 分配其对应的 critic/reward/ref,并启动每个分组的训练:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/launcher.py#L278-L299
为每个 actor 分配对应的 vllm_engine,并使用 vllm_engine 进行推理:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ppo_utils/experience_maker.py#L627
4.1.9 共同部署
同样,我们可以按照自己的需求,选择性地在单卡上部署不同种类的模型,例如下面的例子中, actor/ref 共部署, critic/reward 共部署,图例如下,运作流程和 1 相似,这里不赘述:
4.2 代码实例分析
ppo_ray 相关的训练入口在:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/cli/train_ppo_ray.py
在 main 中我们启动了 driver 进程,并执行训练函数train(args),这里主要做了如下几件事:
- 在 Ray 集群上部署 Actor/Ref/Critic/RM 实例
- 在 Ray 集群上部署 vllm_engines 实例
- 配置 Actor 和 vllm_engines 之间的通讯,用于传递权重
- 训练 Actor 和 Critic 模型
我们依次来解读这几个关键步骤。同时为了在表述上消除歧义,我们接下来谈到“Actor ”时,会使用 Ray-Actor 和 PPO-Actor 来做区分,从之前的介绍中可知, Ray-Actor 是指部署在 Ray 集群中的远端 class, PPO-Actor/Ref/Critic/RM 都属于 Ray-Actor。
4.3 部署 Actor/Ref/Critic/RM 实例
4.3.1 (1)非共同部署
针对图 1 的情况,我们以 PPO-Actor 为例,看代码是如何将其部署到 Ray 集群上的。
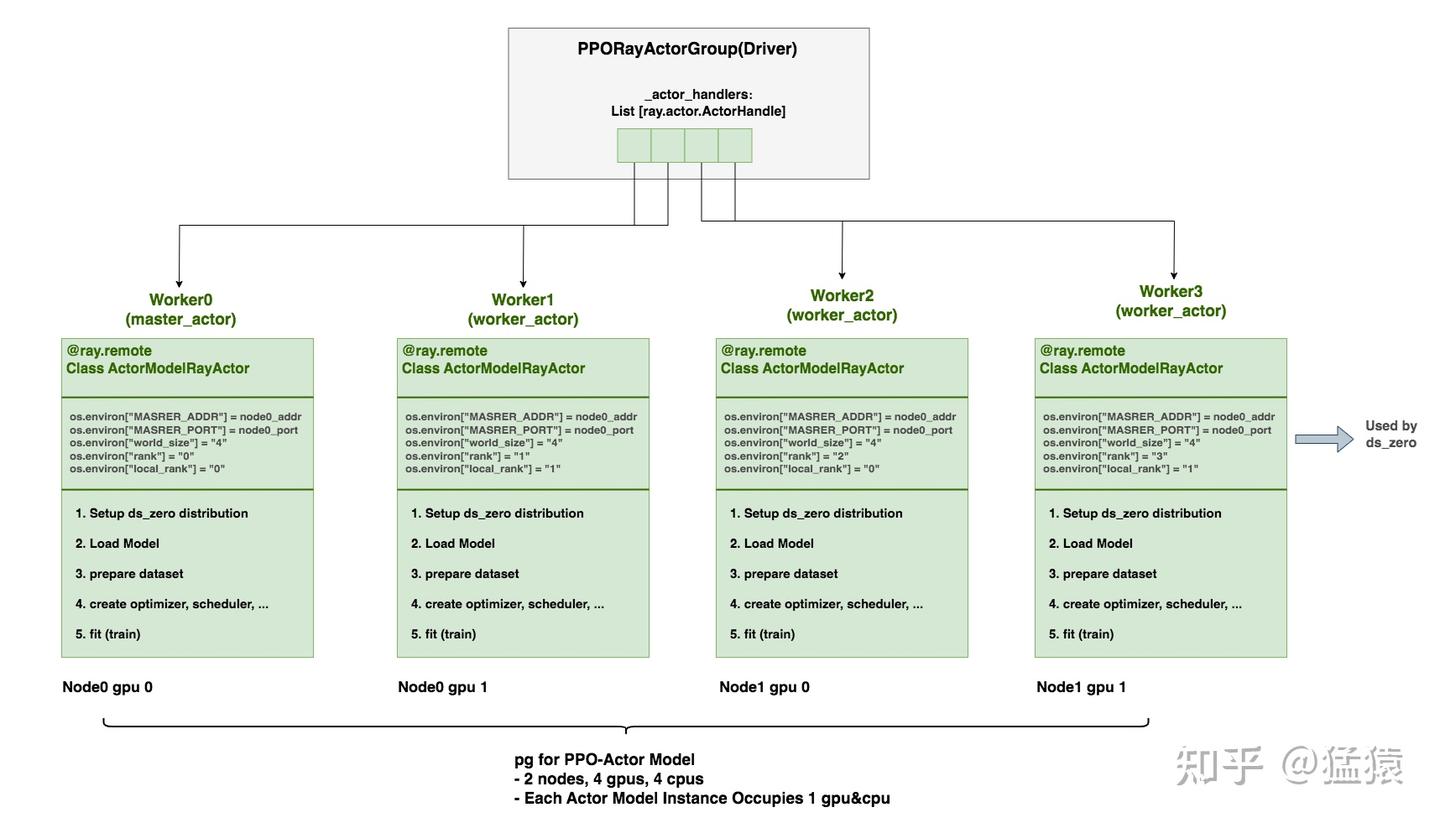
PPORayActorGroup:创建在 driver 进程上,可将它理解成一种部署方案,专门负责部署 PPO 中的 4 类模型。PPORayActorGroup中维护着self._actor_handlers,它是一个List[ray.actor.ActorHandle],列表中每个元素表示某个远端 Ray-Actor 的引用,而这个远端 Ray-Actor 可以是 PPO-Actor/Ref/Critic/RM 实例。如前文所说,我们可以在 Ray 集群中的任何位置调用这个 handler,来对相应的远端 Ray-Actor 执行操作。在本例中,我们创建了 4 个 Ray-Actor (1 个 master-actor, 3 个 worker_actor)。每个 Ray-Actor 都运行在一个 worker 进程中。在创建 Ray-Actor 的同时,我们也会去修改 worker 进程的环境变量。后续当我们在这些 worker 进程中启动 ds_zero 相关的分布式配置时, ds 会读取这些环境变量信息,这样我们就知道哪些 Ray-Actor 同时又构成 ds 中的数据并行组。
使用
PPORayActorGroup部署模型实例的代码如下:
model = PPORayActorGroup(
        # 为部署该模型的全部实例,我们想用多少台node,例如本例中为2
        args.actor_num_nodes,
        # 为部署该模型的全部实例,我们每台node上想用多少gpu,例如本例中为2
        args.actor_num_gpus_per_node,
        # Actor/Critic/Reward/ReferenceRayActor
        ActorModelRayActor,
        # pg可理解为,在ray cluster中锁定/预留一片资源,然后只在这片资源上部署该模型全部实例。
        # (pg维护在Head Node的GCS上,参见3.3)
        # 例如本例中,pg锁定的资源为node0 gpu0/1, node1 gpu0/1,
        # 我们只在上面部署ActorModelRayActor全部实例
        pg=pg,
        # 当我们在pg指向的预留资源中分配模型实例时,再进一步指定每个实例占据一张gpu的多少部分
        # 等于1说明每个实例占满一张gpu,即“非共同部署”
        # 小于1说明每个实例只占部分gpu,即“共同部署”,例如PPO-Actor/Ref共同部署在一张卡上
        num_gpus_per_actor=0.75 if pg else 1,
)ActorModelRayActor:创建在远端 worker 进程上,是 Ray-Actor。它包含了设置 ds_zero 分布式环境、加载模型权重、数据集准备、optimizer/scheduler 准备、训练等一系列操作。
PPORayActorGroup代码参见:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/launcher.py#L143 根据这份代码,大家可自行去找 Actor/Critic/Reward/ReferenceRayActor 的相关实现。
4.3.2 (2)共同部署
针对图 2 的情况,我们以 PPO-Actor 为例,看代码是如何将其部署到 Ray 集群上的。
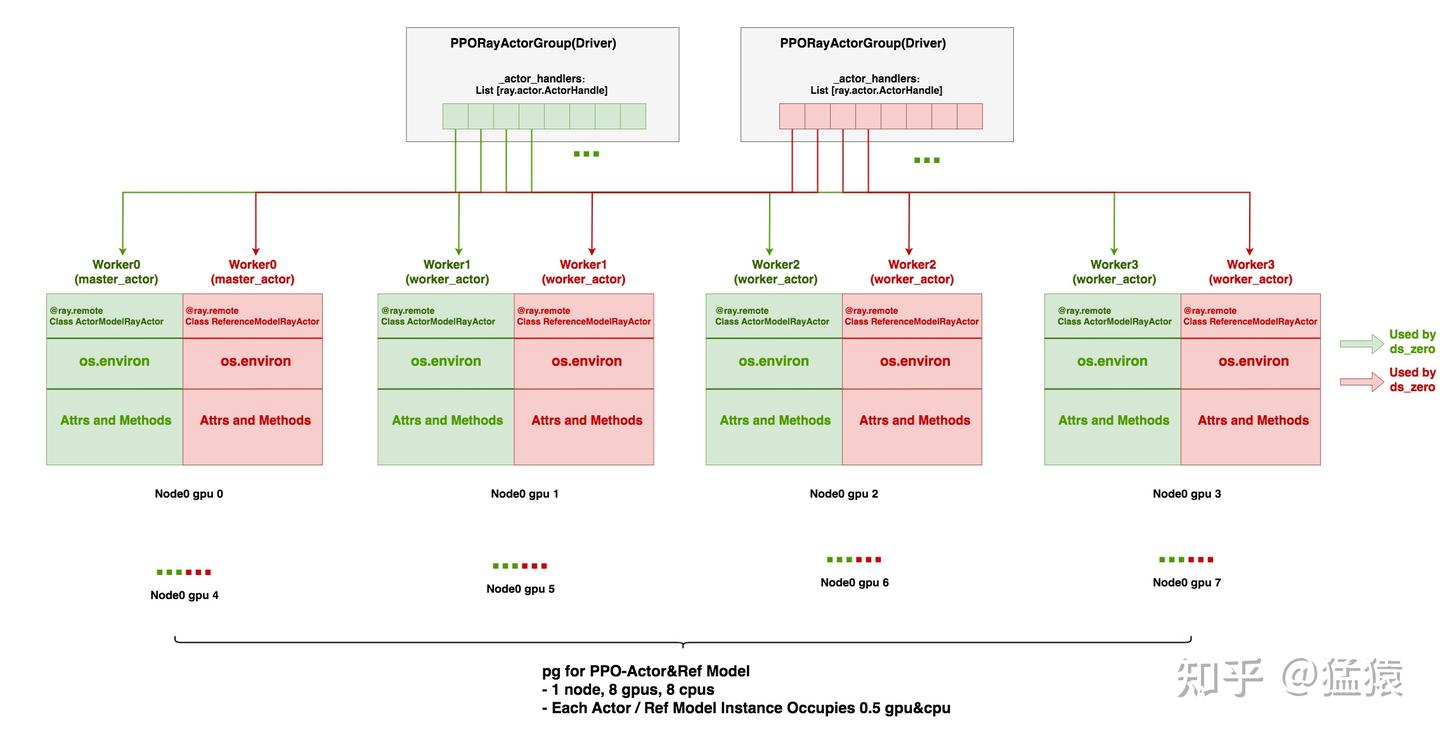
PPORayActorGroup:在 driver 进程上创建 2 个PPORayActorGroup,分别管理 PPO-Actor, PPO-Ref 的部署使用
actor_model = PPORayActorGroup(..., pg = pg, num_gpus_per_actor=0.75)创建 PPO-Actor 部署方案实例;使用
ref_model = PPORayActorGroup(..., pg = pg, num_gpus_per_actor=0.25)创建 PPO-Ref 部署方案实例。这里,两个方案实例使用的 pg 都是同一个,即这个 pg 都指向“1 台 node,每台 node 8 张卡”这片预留好的资源。
num_gpus_per_actor = 0.75/0.25是一种创建 trick,虽然我们的最终目的是为了让 PPO-Actor 和 PPO-Ref 对半分一张卡(对半=共享,不是指显存上对半分),但是:- 假设设置为 0.5,当我们实际部署
ActorModelRayActor时, Ray 先在单卡上部署 1 个ActorModelRayActor实例,当它准备部署第二个ActorModelRayActor实例时,它发现由于每个实例只占 0.5 块卡,因此完全可以把第 2 个实例接着第 1 个实例在同一张卡上部署,这样就导致最终无法让 PPO-Actor 和 PPO-Ref 共享一张卡 - 假设设置 0.75,当我们在单卡上部署完 1 个
ActorModelRayActor实例后, Ray 发现单卡剩下的空间不足以部署第 2 个ActorModelRayActor实例,所以就会把第二个实例部署到别的卡上,这样最终实现 PPO-Actor 和 PPO-Ref 共享一张卡 - 所以,这个设置是为了达到不同类型模型的实例共享一张卡的目的,而并非真正指模型实际占据的单卡显存空间。
- 假设设置为 0.5,当我们实际部署
最后,在这一步中,我们对全部
ActorModelRayActor共创建 8 个 worker 进程,对全部RefenreceModelRayActor共创建 8 个 worker 进程,一共创建 16 个工作进程。
相关代码依然在:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/launcher.py#L143
4.4 部署 vllm_engines 实例
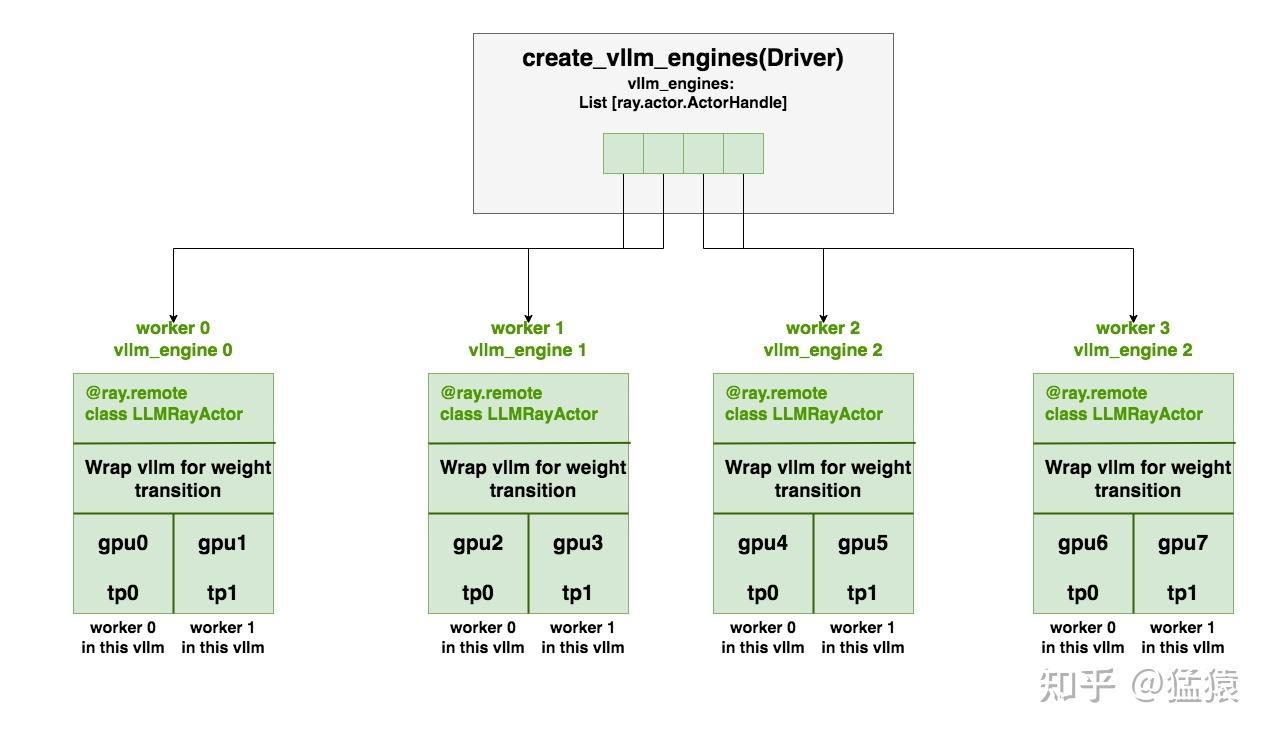
create_vllm_engines:在 driver 端,我们通过运行该函数来创建vllm_engines,过程相似于 4.2 节中的介绍,信息都在图中,这里不赘述。LLMRayActor: worker 端 Ray-Actor,它主要是把 vLLM 实例进行了一些包装,包装的目的是为了让 ds_rank0 和 all vLLM ranks 间可以进行 PPO-Actor 的权重通讯(参见 2.1 (3))- 在上面的例子中,我们会创建 4 个 worker 进程(不占 GPU 资源,只占 CPU 资源),用于运行管理 4 个 vllm_engine。在每个 worker 进程内, vLLM 实例还会创建属于自己的 worker 进程做分布式运行(这些 worker 进程会实际占据 GPU 资源)。
相关代码参见: https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/vllm_engine.pyhttps://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/vllm_worker_wrap.py
4.5 ds_rank0 与 vllm_ranks 之间的通讯
在 2.2 中,我们说过, PPO-Actor 的 ds_rank0 需要和 all_vllm_ranks 进行通讯,传递最新的 PPO-Actor 权重,例如以下 ds_rank0 要把完整的权重 broadcast 给 16 个 vllm_ranks:
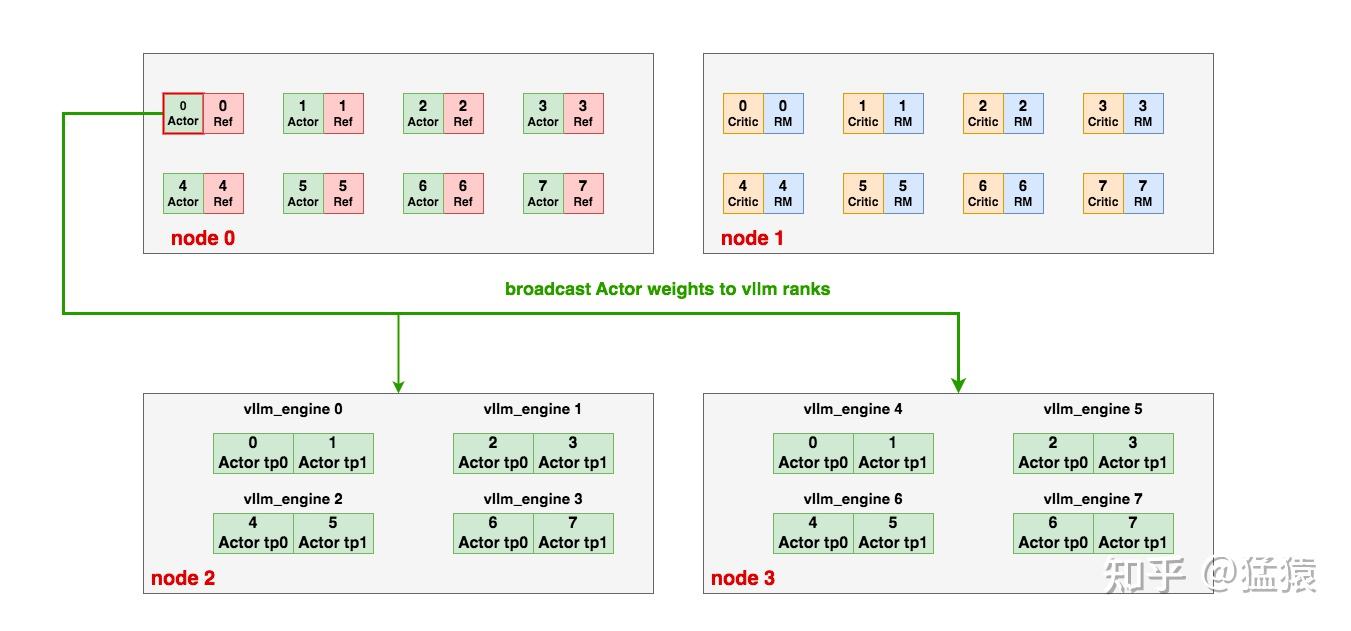
我们分成如下几步实现这个目标:
4.5.1 (1)创建通信组
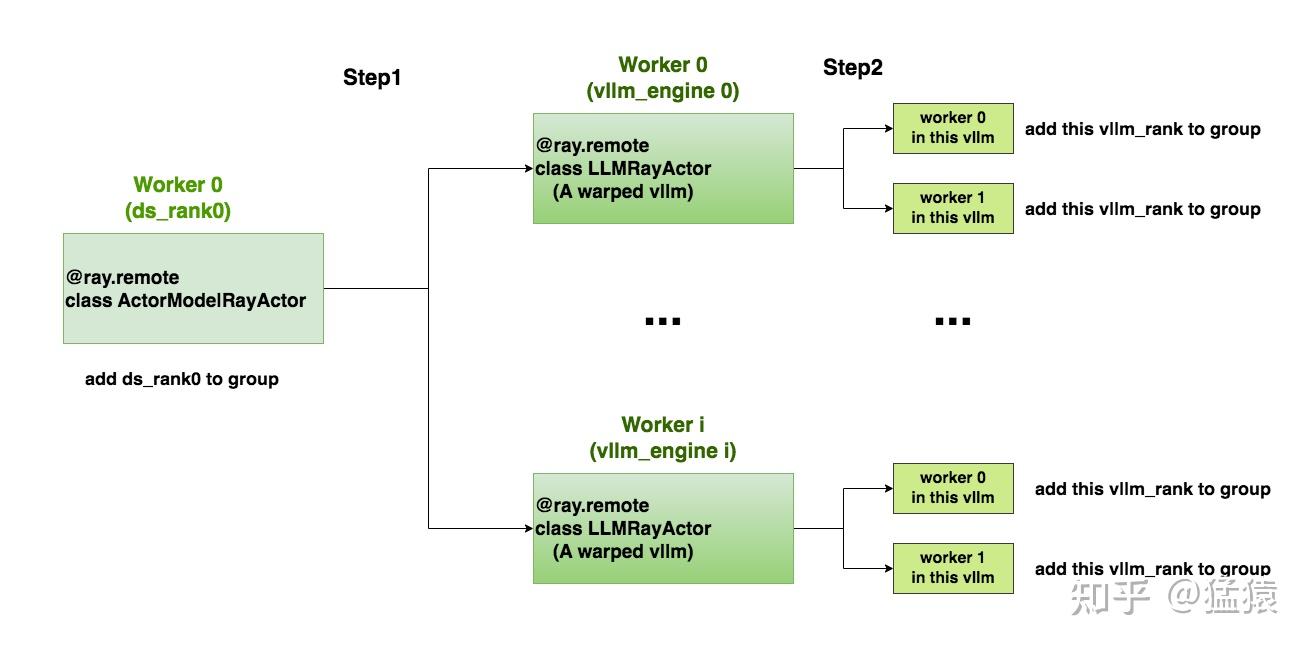
Step1:
代码来自:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/ppo_actor.py#L58 这段代码执行在 PPO-Actor0 (ds_rank0)所在的 worker 进程中。这个 worker 进程将通过 handler 引用,触发远端每个 vllm_engine 上的 init_process_group 操作,并将 ds_rank0 纳入通讯组
        # Create torch group with deepspeed rank 0 and all vllm ranks
        # to update vllm engine's weights after each training stage.
        #
        # Say we have 3 vllm engines and eache of them has 4 GPUs,
        # then the torch group is:
        # [    0,      1, 2, 3, 4,  5, 6, 7, 8,  9, 10, 11, 12]
        # |ds rank 0 |  engine-0  |  engine-1  |   engine-2   |
        #
        # For ZeRO-1/2:
        #   1. Broadcast parameters from rank 0 to all vllm engines
        # For ZeRO-3:
        #   1. AllGather paramters to rank 0
        #   2. Broadcast parameters from rank 0 to all vllm engines
        if self.vllm_engines is not None and torch.distributed.get_rank() == 0:
            ...
            # world_size = num_of_all_vllm_ranks + 1 ds_rank0
            world_size = vllm_num_engines * vllm_tensor_parallel_size + 1
            ...
            # =====================================================================
            # 遍历每个vllm_engines,将其下的每个vllm_rank添加进通讯组中,这里又分成两步:
            # 1. engine.init_process_group.remote(...):
            #    首先,触发远程vllm_engine的init_process_group方法
            # 2. 远程vllm_engine是一个包装过的vllm实例,它的init_process_group
            #    方法将进一步触发这个vllm实例下的各个worker进程(见4.4图例),
            #    最终是在这些worker进程上执行“将每个vllm_rank"添加进ds_rank0通讯组的工作
            # =====================================================================
            refs = [
                engine.init_process_group.remote(
                    # ds_rank0所在node addr
                    master_address,
                    # ds_rank0所在node port
                    master_port,
                    # 该vllm_engine的第一个rank在"ds_rank0 + all_vllm_ranks“中的global_rank,
                    # 该值将作为一个offset,以该值为起点,可以推算出该vllm_engine中其余vllm_rank的global_rank
                    i * vllm_tensor_parallel_size + 1,
                    world_size,
                    "openrlhf",
                    backend=backend,
                )
                for i, engine in enumerate(self.vllm_engines)
            ]
            # =====================================================================
            # 将ds_rank0添加进通讯组中
            # =====================================================================
            self._model_update_group = init_process_group(
                backend=backend,
                init_method=f"tcp://{master_address}:{master_port}",
                world_size=world_size,
                rank=0,
                group_name="openrlhf",
            )
            # =====================================================================
            # 确保all_vllm_ranks都已添加进通讯组中
            # =====================================================================
ray.get(refs)Step2:
代码来自:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/vllm_worker_wrap.py#L11
这段代码实际运行在每个 vllm_engine (即每个包装后的 vLLM 实例)下的 worker 进程内。例如 tp_size=2,那么每个 vLLM 实例下就有 2 个 worker 进程,这两个 worker 进程都会运行这段代码。
class WorkerWrap(Worker):
    def init_process_group(self, master_address, master_port, rank_offset, world_size, group_name, backend="nccl"):
        """Init torch process group for model weights update"""
        assert torch.distributed.is_initialized(), f"default torch process group must be initialized"
        assert group_name != "", f"group name must not be empty"
        # =====================================================================
        # torch.distributed.get_rank(): 在当前vllm_engine内部的rank,
        #                               例如在tp_size = 2时,这个值要么是0,要么是1
        # rank_offset:当前vllm_engine中的第一个rank在“ds_rank0 + all_vllm_ranks"中的global_rank
        # 两者相加:最终得到当前rank在“ds_rank0 + all_vllm_ranks"中的global_rank
        # =====================================================================
        rank = torch.distributed.get_rank() + rank_offset
        self._model_update_group = init_process_group(
            backend=backend,
            init_method=f"tcp://{master_address}:{master_port}",
            world_size=world_size,
            rank=rank,
            group_name=group_name,
        )
...4.5.2 (2)_broadcast_to_vllm
构建好通讯组,我们就可以从 ds_rank0 广播 PPO-Actor 权重到 all_vllm_ranks 上了,这里也分成两步。
Step1: PPO-Actor ds_rank0 发送权重
代码在:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/ppo_actor.py#L146 这段代码运行在 ds_rank0 对应的 worker 进程中
      def _broadcast_to_vllm(self):
        # avoid OOM
        torch.cuda.empty_cache()
        model = self.actor.model.module
        count, num_params = 0, len(list(model.named_parameters()))
        for name, param in model.named_parameters():
            count += 1  # empty_cache at last param

            # Fire all vllm engines for broadcast
            if torch.distributed.get_rank() == 0:
                shape = param.shape if self.strategy.args.zero_stage != 3 else param.ds_shape
                refs = [
                    # 远端vllm_engine的每个rank上,初始化一个尺寸为shape的empty weight张量,
                    # 用于接收广播而来的权重
                    engine.update_weight.remote(name, dtype=param.dtype, shape=shape, empty_cache=count == num_params)
                    for engine in self.vllm_engines
                ]

            # For ZeRO-3, allgather sharded parameter and broadcast to all vllm engines by rank 0
            # ds_rank0发出权重(视是否使用zero3决定在发出前是否要做all-gather)
            with deepspeed.zero.GatheredParameters([param], enabled=self.strategy.args.zero_stage == 3):
                if torch.distributed.get_rank() == 0:
                    torch.distributed.broadcast(param.data, 0, group=self._model_update_group)
ray.get(refs) # 确保所有vllm_ranks接收权重完毕Step2: 各个 vllm_ranks 接收权重
代码在:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/vllm_worker_wrap.py#L29 代码运行在每个 vllm_engine(即每个包装后的 vLLM 实例)下的各个 worker 进程中。例如 tp_size = 2,那么每个 vLLM 实例下有 2 个 worker 进程,这 2 个 worker 进程都会运行这段代码。
    def update_weight(self, name, dtype, shape, empty_cache=False):
        """Broadcast weight to all vllm workers from source rank 0 (actor model)"""
        if torch.distributed.get_rank() == 0:
            print(f"update weight: {name}, dtype: {dtype}, shape: {shape}")

        assert dtype == self.model_config.dtype, f"mismatch dtype: src {dtype}, dst {self.model_config.dtype}"
        # 创建同尺寸空张量用于接收ds_rank0广播来的权重
        weight = torch.empty(shape, dtype=dtype, device="cuda")
        # 接收权重
        torch.distributed.broadcast(weight, 0, group=self._model_update_group)
        # 使用接收到的权重进行更新
        self.model_runner.model.load_weights(weights=[(name, weight)])

del weight4.6 PPO-Actor/Critic Training
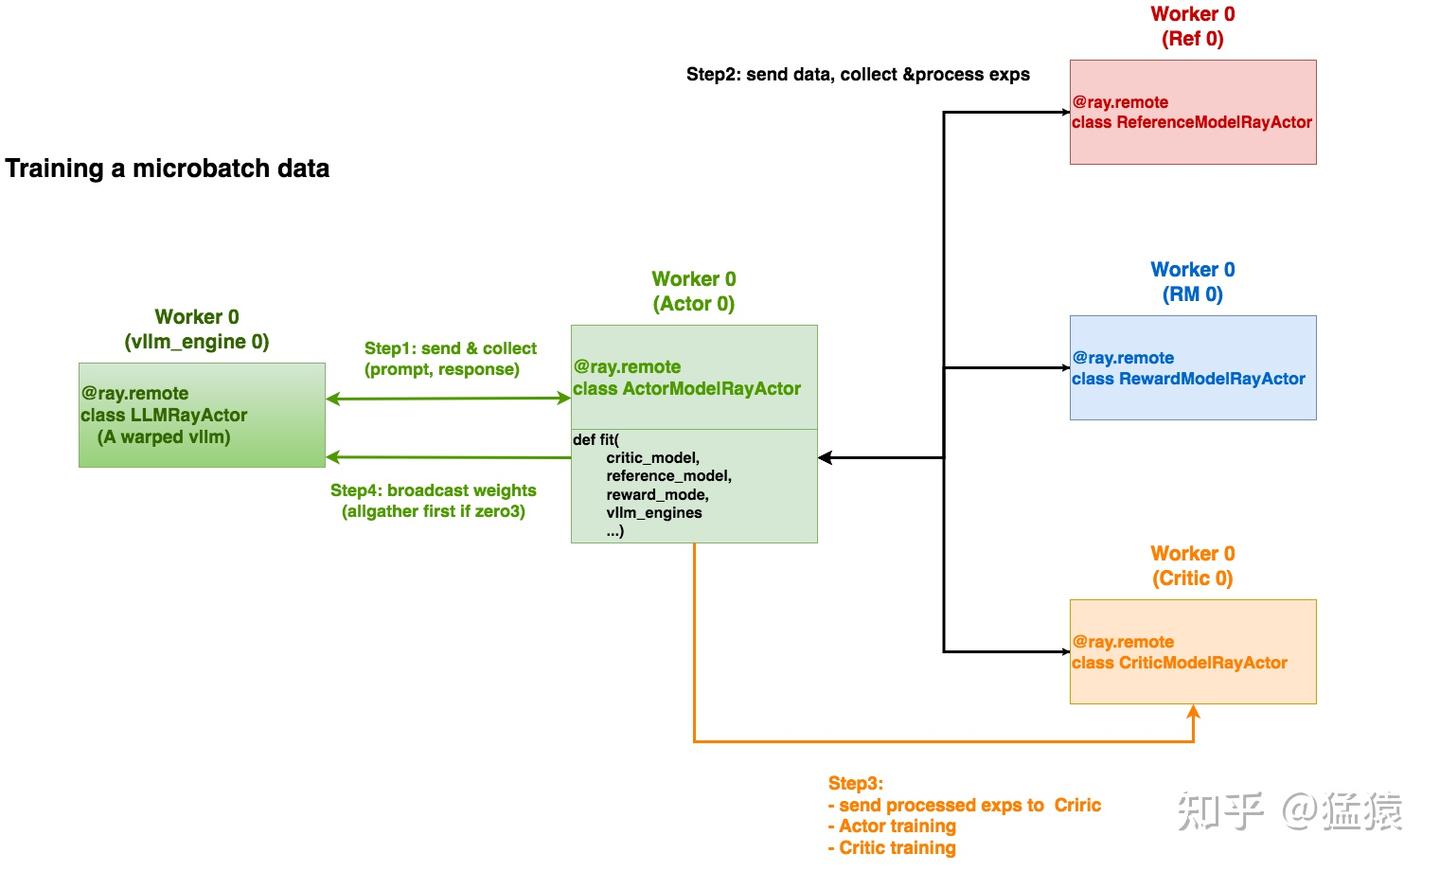
正如 2.1 (4)中所说,我们将部署在 Ray 集群上的 PPO-Actor/Ref/Critic/RM 实例们进行分组,每组分别负责一份 micro-batch 的训练,上图刻画了某个组内的训练流程。一组内的训练流程发起自 PPO-Actor 实例(fit 方法),注意不同颜色的 worker0 表示的是不同工作进程。共分成如下步骤执行。
Step1:发送 prompts,并从 vllm_engine 上收集(prompt, response)。
代码参见:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ppo_utils/experience_maker.py#L627
Step2:从 Ref/Reward/Critic 上收集并处理 exps
代码参见:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ppo_utils/experience_maker.py#L492
Step3: 确保将处理后的 exps 传送给 Critic,并行执行 Actor 和 Critic 的训练
将 exps 传送给 Critic:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ppo_utils/experience_maker.py#L470
Actor 训练:
https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/ppo_actor.py#L125
Critic 训练:
https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/ppo_actor.py#L122
我们在 Actor 实例所在的 worker 进程上出发 Actor 和 Critic 的训练。
Step4: vllm_engine 权重更新。
代码参见:https://github.com/OpenRLHF/OpenRLHF/blob/main/openrlhf/trainer/ray/ppo_actor.py#L130